AI 时代,我为什么开始追求 100% 的测试覆盖率?
关键词:AI Agent、测试覆盖率、100%覆盖率、Codecov、CI门禁、Benchmark、红蓝对抗、黑客松、AI编程、测试工程、代码覆盖率、CI/CD、软件工程在传统软件工程里,追逐 100% 覆盖率往往被认为是“形式主义”或“边际成本过高”。但在当下这个 AI 编码的新时代,这套逻辑被彻底颠覆了。分享一下我最近的实践和思考。
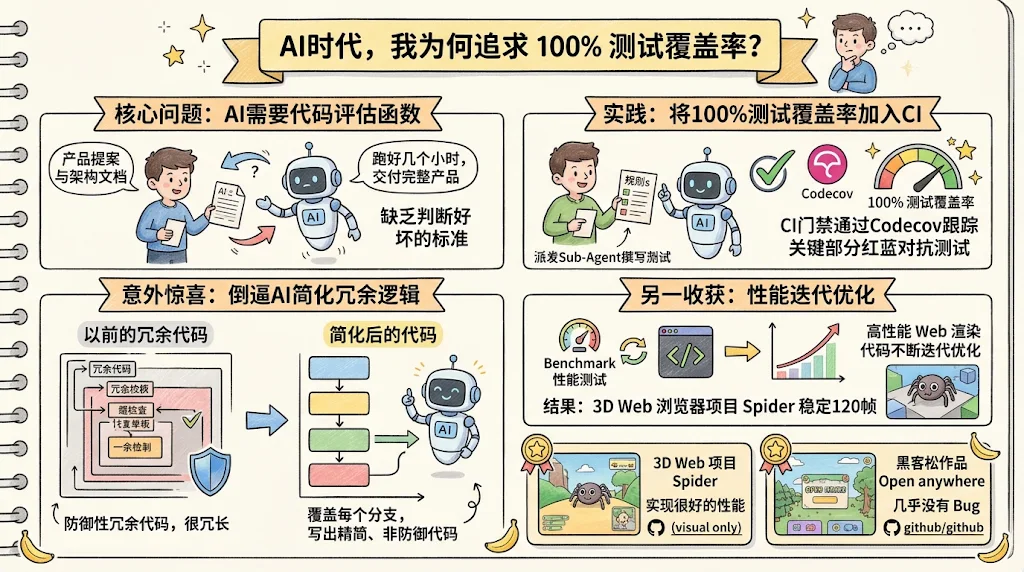
最近参加了一场公司的黑客松比赛,同时也在推进自己的个人项目。在这两个项目中,我做了一个看似有些“偏执”的决定:将测试覆盖率指标强制提升到 100%。
我们将这个要求写入了 CI 门禁,通过 Codecov 进行实时跟踪,并在 README 中展示 Badge。
- 3D Web 项目 Spider:https://github.com/minorcell/spider
- 黑客松作品 Open Anywhere:https://github.com/open-anywhere/open-anywhere
在传统软件工程里,追逐 100% 覆盖率往往被认为是“形式主义”或“边际成本过高”。但在当下这个 AI 编码的新时代,这套逻辑被彻底颠覆了。分享一下我最近的实践和思考。
测试,就是 AI 编程的“评估函数”
如今我们的开发模式已经发生了根本性的改变:开发者越来越多地退居为产品设计者与架构拆解者。
一份结构清晰的 Proposal,一份合理的架构拆解文档,直接丢给 AI Agent,它就能不眠不休地跑上几个小时,交付出一个功能完整的产品。
但大模型在训练时,依靠评估函数(Evaluation Function / Reward Model)来判断每一步迭代的好坏,从而逐步收敛到最优解。那么在 AI Agent 替我们写代码的环节,它的“评估函数”是什么?
测试一定是评估函数中比较重要的一部分。
没有测试,AI 的生成就是无锚漂泊;而 100% 的测试覆盖率,就是给 AI 建立一套极其严密、确定的反馈机制。
在最近的项目中,我们甚至引入了类似网络安全中“红蓝对抗”的机制:让主 Agent 派发独立的 Sub-Agent 专门扮演攻防角色去撰写测试用例,在代码合并前提早挖掘边缘死角。
实践的结果非常惊人:在程序逻辑层面,几乎做到了零 Bug。 后续一些 Fix 提交,也仅仅是因为我们在产品决策层面的调整,而非代码质量缺陷。
意外惊喜:100% 覆盖率倒逼 AI 消除“防御性冗余”
在使用 AI 协同写代码时,大家经常吐槽的一点是:AI 写的代码太臃肿了。一个简单的逻辑,它可能会习惯性地嵌套好几层防御性判断(Null Check、边界兜底等)。
但当我们将测试覆盖率硬性设定为 100% 后,奇妙的事情发生了——AI 开始主动精简自己的代码逻辑。
因为严格的测试框架(如 Vitest Code Coverage、Go Code Coverage )要求每一个分支(Branch)、每一个条件判断必须被测试用例真实击中。如果 AI 写了 5 层防御性判断,它就必须为这 5 层极其罕见的分支各自编写测试用例。
来看一个具体的 TypeScript 对比示例:
场景:编写一个简单的用户 ID 格式化函数。
AI 的直觉是“安全第一”,因此会习惯性地编写大量虽然符合类型检查,但逻辑上可能永远不会跑进去的代码。
// formatUserId.ts
interface UserInfo {
  id?: string | number;
  prefix?: string;
}

export function formatUserId(user: UserInfo | null | undefined): string {
  // 防御性判断 1: 输入为空
  if (!user) {
    return 'GUEST_000';
  }

  // 防御性判断 2: id 不存在或为空
  if (user.id === null || user.id === undefined || user.id === '') {
    return 'UNKNOWN_000';
  }

  // 防御性判断 3: 处理 number 类型的 id
  let finalId: string;
  if (typeof user.id === 'number') {
    finalId = user.id.toFixed(0); // 确保没有小数
  } else {
    // 防御性判断 4: 兜底 string 类型
    finalId = String(user.id);
  }

  // 处理前缀逻辑
  const prefix = user.prefix ? user.prefix.trim() : 'USER';
  return `${prefix}_${finalId}`;
}
为了让这段代码达到 100% Branch Coverage,AI(或人类)必须编写 6~7 个测试用例来覆盖:
- Input 为 null
- Input 为 {}
- id 为 ''
- id 为 number
- id 为 string
- prefix 存在、为空、全空格。
100% 覆盖率倒逼下,AI 生成的“精简版”代码:
当 AI 意识到编写那些防御分支的测试用例成本,高于精简逻辑本身时,它会更倾向于使用现代语法和合理的上游类型约束来简化逻辑。
// formatUserId.ts (精简版)
interface UserInfo {
  // 合理的上游类型约束,避免下游做各种空判断
  id: string | number;
  prefix?: string;
}

export function formatUserId(user: UserInfo): string {
  // 利用 Nullish Coalescing and Optional Chaining 简化分支
  const prefix = user.prefix?.trim() || 'USER';

  // 利用 String 构造函数简化类型转换判断
  const finalId = String(user.id);

  return `${prefix}_${finalId}`;
}
为了满足 100% 覆盖率的要求,AI 在自我纠偏的过程中,被迫学会了写出精简、直接、无冗余防御的代码。这种“倒逼”机制,让生成的代码质量得到了肉眼可见的优雅提升。
从单元测试到 Benchmark:在 3D Web 中跑出 120 帧
除了常规的单元测试、集成测试和 E2E 之外,我们还在核心关键路径上强制加入了 Benchmark 性能测试。
以我们的 3D 浏览器渲染项目 Spider 为例,在 Web 端做 3D 场景渲染,性能瓶颈极其敏感。我们通过把 Benchmark 结果作为指标嵌入反馈循环,让 AI 不断根据性能数据迭代优化代码逻辑。
最终,这个 3D Web 项目在我们的测试环境中实现了 120 帧稳定流畅运行,一些四五年前的笔记本都可以流畅运行。
在此体验: 蛛小八
正是这种“测试/性能基准 -> 数据反馈 -> AI 针对性重构”的闭环,让原本复杂的性能调优变得可量化、可自动迭代。
结语
在人类手写代码的时代,追求 100% 覆盖率受限于人力与时间成本;但在 AI 代理执行的时代,编写测试和重构代码的边际成本已经被压缩到了极限。
测试不再是开发的负担,而是控制 AI 能量狂飙的缰绳。
如果你也在让 AI 承接大面积的代码交付,不妨试试给它装上 100% 测试覆盖率的“评估函数”,看看它能带给你怎样的惊喜。